AI wraca z chmury na biurko. Czy lokalne modele zmienią ekonomię sztucznej inteligencji?
25 września 2026 | Zespół lab-kuzniewski.pl
Przez ostatnich kilka lat przyzwyczailiśmy się do bardzo prostego modelu działania generatywnej sztucznej inteligencji. Na naszym komputerze otwieramy aplikację albo przeglądarkę, wpisujemy prompt, a kluczowa dla zrealizowania naszego polecenia praca odbywa się setki lub tysiące kilometrów dalej - w centrach danych wypełnionych akceleratorami kosztującymi dziesiątki tysięcy dolarów sztuka.
ChatGPT, Claude, Gemini i większość pozostałych popularnych usług AI funkcjonuje właśnie w taki sposób. Lokalny komputer jest przede wszystkim terminalem komunikującym się z ogromną infrastrukturą dostawcy usługi opartej na zaawansowanym LLM. Użytkownik nie musi wiedzieć, na jakim sprzęcie działa model, ile pamięci potrzebuje ani ile energii pochłania generowanie odpowiedzi.
W zamian płaci bezpośrednio abonamentem albo - w przypadku zastosowań biznesowych i API - za faktyczne wykorzystanie modelu. Podstawową jednostką takiego rozliczenia są tokeny, czyli niewielkie fragmenty informacji przetwarzanej przez model. W przypadku tekstu token może odpowiadać całemu krótkiemu słowu, jego części, znakowi interpunkcyjnemu albo kilku znakom. Dostawca może osobno naliczać tokeny przesłane do modelu oraz wygenerowane przez niego w odpowiedzi.
Ten system może jednak niebawem zacząć się zmieniać.
Apple właśnie rozpoczęło sprzedaż Maców Studio z układem M5 Ultra, wyposażanych nawet w 512 GB zunifikowanej pamięci o przepustowości 1,2 TB/s. Najsłynniejsza „firma sadownicza” nie przedstawia przy tym nowego Maca Studio wyłącznie jako kolejnej stacji roboczej dla montażystów, projektantów 3D czy inżynierów. Jednym z głównych zastosowań nowej konstrukcji ma być lokalne uruchamianie bardzo dużych modeli AI. Kilka Maców Studio można ponadto połączyć przez Thunderbolt 5 i RDMA w klaster współdzielący zasoby potrzebne do inferencji. Apple deklaruje nawet trzykrotnie większą wydajność takiego czterowęzłowego zestawu względem pojedynczego komputera.
Podczas demonstracji przeprowadzonej wspólnie z LM Studio cztery komputery Mac Studio uruchomiły Kimi K2.6 - model o około bilionie parametrów. System rozdzielono pomiędzy pamięć czterech maszyn połączonych przez Thunderbolt 5 z wykorzystaniem RDMA. Apple pokazywało ten scenariusz już podczas WWDC 2026, więc wrześniowa premiera sprzętu nie jest nagłym marketingowym pomysłem, lecz kolejnym elementem rozwijanej od miesięcy strategii.
Sam fakt, że kilka komputerów stojących na biurku potrafi uruchomić model tej skali, robi wrażenie. Ciekawsza jest jednak ekonomiczna narracja towarzysząca premierze. Johny Srouji, odpowiedzialny w Apple za technologie sprzętowe, zwrócił uwagę, że po zakupie takiej maszyny użytkownik nie płaci już za każdy kolejny token. Reuters opisuje obecną strategię Apple wprost jako próbę przekonania firm, że przy odpowiednio intensywnym wykorzystaniu AI własny sprzęt może stać się alternatywą dla ciągłego kupowania mocy obliczeniowej w chmurze.
Brzmi jak powrót do przeszłości?
Trochę tak.
Po kilkunastu latach przekonywania nas, że przyszłość należy do chmury, część branży technologicznej zaczyna ponownie zadawać pytanie: a może jednak opłaca się mieć mocny komputer na własnym biurku?
Bilion parametrów na biurku nie oznacza końca centrów danych
Zanim cztery komputery Mac Studio obwołamy zamiennikiem centrum danych OpenAI, trzeba uporządkować kilka pojęć.
Najważniejsza jest różnica między treningiem modelu a inferencją.
Trening to proces tworzenia modelu. Ogromne ilości danych są wielokrotnie przetwarzane przez klastry składające się z tysięcy lub dziesiątek tysięcy akceleratorów, a algorytmy stopniowo modyfikują parametry sieci neuronowej. To właśnie ten etap odpowiada za astronomiczne budżety, rozbudowę centrów danych i ogromne zapotrzebowanie na energię.
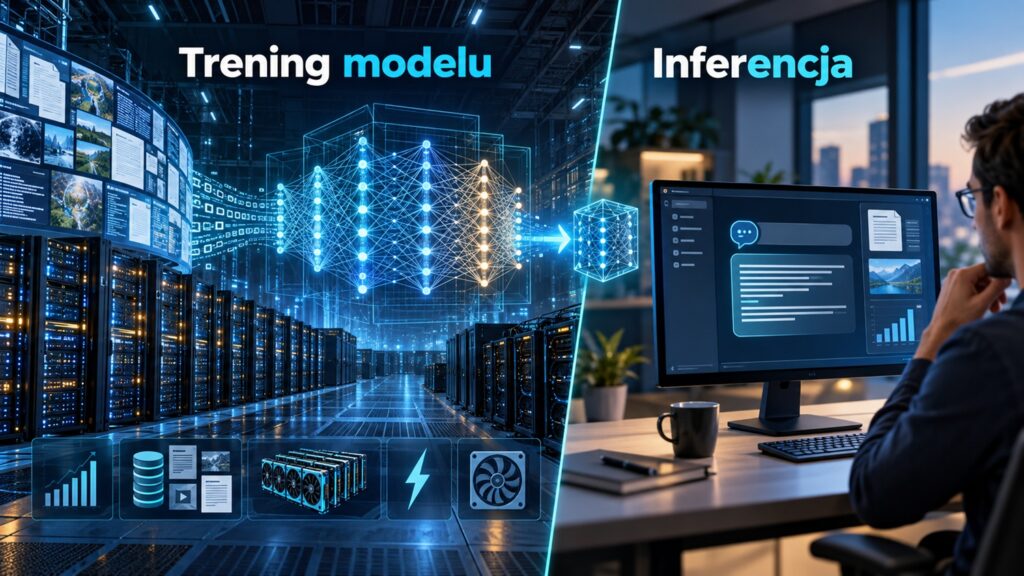
Inferencja zaczyna się później. Model jest już wytrenowany i otrzymuje konkretne zadanie: odpowiedz na pytanie, napisz kod, przeanalizuj dokument, wygeneruj obraz albo zdecyduj, jaki kolejny krok powinien wykonać agent AI.
Nowe Maki, DGX Spark czy komputery z Ryzen AI Max nie zastępują infrastruktury służącej do trenowania największych modeli świata. Pozwalają natomiast coraz częściej uruchamiać gotowe modele lokalnie, bez wysyłania każdego polecenia do zewnętrznego centrum danych.
Warto również uważać na robiącą ogromne wrażenie liczbę biliona parametrów.
Kimi K2.6 wykorzystuje architekturę Mixture-of-Experts, czyli MoE. Model ma około biliona parametrów łącznie, ale podczas przetwarzania pojedynczego tokenu aktywne są około 32 miliardy. Można to sobie wyobrazić jak ogromny zespół specjalistów, z którego do każdego konkretnego problemu wybierana jest tylko część najbardziej przydatnych ekspertów.
Nie oznacza to, że pozostałe parametry można po prostu wyrzucić z pamięci. Model nadal musi mieć do nich dostęp, aby móc wybierać odpowiednie „eksperckie” fragmenty sieci. Zmniejsza się jednak liczba obliczeń wykonywanych dla każdego tokenu. Dlatego model mający bilion parametrów w architekturze MoE nie zachowuje się pod względem zapotrzebowania na moc obliczeniową tak samo jak hipotetyczny gęsty model aktywujący cały bilion parametrów podczas każdej operacji.
To ważne zastrzeżenie, ale nie odbiera demonstracji znaczenia. Jeszcze kilka lat temu możliwość uruchamiania modeli tej klasy na sprzęcie stojącym pod monitorem należałaby raczej do kategorii technologicznych ciekawostek niż realnych scenariuszy biznesowych.
Problem z AI zaczyna się po jej wytrenowaniu
Koszt stworzenia wielkiego modelu jest spektakularny, ale z perspektywy dostawcy usługi równie ważne jest inne pytanie: ile kosztuje jego późniejsze używanie przez miliony ludzi?
Weźmy GPT-6 Astra, któremu poświęciliśmy poprzedni materiał na LAB-ie. Standardowa cena API wynosi obecnie 10 dolarów za milion tokenów wejściowych i 50 dolarów za milion tokenów generowanych przez model. Przy bardzo długich kontekstach stawki są wyższe.
Milion tokenów brzmi jak ogromna ilość tekstu i przy okazjonalnym pytaniu rzeczywiście trudno się tym przejmować.
Jednak sytuacja radykalnie zmienia się, gdy do akcji wkraczają agenci.
Klasyczny chatbot otrzymuje pytanie, generuje odpowiedź i kończy pracę. Agent może dostać polecenie typu: „przeanalizuj tę dokumentację, sprawdź projekt, znajdź błędy, popraw kod, uruchom testy i przygotuj raport”.
Następnie przez pół godziny lub kilka godzin wykonuje kolejne operacje: czyta pliki, analizuje kontekst, generuje plan, wywołuje narzędzia, przegląda Internet, uruchamia kod, sprawdza rezultat, poprawia plan i zaczyna następny etap. Każda taka czynność może oznaczać zużycie kolejnych tysięcy lub milionów tokenów.
Właśnie dlatego Microsoft podczas Build 2026 użył określenia „unmetered intelligence” - inteligencja bez licznika. Firma rozwija jednocześnie Aion 1.0 Plan - 14-miliardowy model z kontekstem 32K, przygotowany do lokalnego rozumowania, korzystania z narzędzi, zarządzania plikami oraz koordynowania innych agentów.
Nie chodzi więc wyłącznie o możliwość pogadania z chatbotem podczas awarii Internetu.
Chodzi o to, aby agent pracujący przez osiem godzin nie uruchamiał przez osiem godzin taksometru po stronie dostawcy chmury.
Ale chmura też nie stoi w miejscu
Na tym etapie łatwo byłoby dojść do wniosku, że lokalne modele mają oczywistą przewagę ekonomiczną.
Kupujemy komputer raz, używamy go przez trzy czy pięć lat i nie płacimy za każdy token. Proste.
Tyle że druga strona również rozwija technologię i robi to bardzo szybko.
22 września Anthropic zaprezentowało Claude Opus 5.5. Nowy model kosztuje 4 dolary za milion tokenów wejściowych i 20 dolarów za milion wyjściowych. Firma szacuje, że typowe zadanie kosztuje około 40 procent mniej niż w przypadku Opus 5, między innymi dzięki obniżeniu cen samego modelu oraz bardzo mocnemu potanieniu odczytu buforowanego kontekstu.
OpenAI również ma całą drabinkę cenową. GPT-6 Sol kosztuje standardowo 2 dolary za milion tokenów wejściowych i 10 dolarów za wyjściowe, natomiast GPT-6 Luna schodzi odpowiednio do 10 i 50 centów.
Powstają więc dwa przeciwstawne trendy.
Producenci sprzętu próbują doprowadzić koszt marginalny lokalnej inferencji jak najbliżej zera - oczywiście pomijając energię, amortyzację sprzętu, administrację i czas użytkownika.
Dostawcy chmury próbują natomiast sprawić, aby sam token kosztował coraz mniej.
To komplikuje każdą próbę racjonalnego wyliczenia momentu, w którym zakup własnego komputera „zaczyna się opłacać”.
Stacja robocza kupiona dzisiaj ma określoną wydajność przez cały okres eksploatacji. Model w chmurze za rok może być szybszy, inteligentniejszy i kilkukrotnie tańszy. Z drugiej strony firma wykonująca codziennie miliony powtarzalnych operacji AI może po zakupie infrastruktury lokalnej przestać przejmować się tym, czy każdy kolejny proces agenta kosztuje 20 centów, dwa czy dwadzieścia dolarów.
Nie ma więc jednej uniwersalnej drogi do ekonomicznego korzystania z AI.
Nagle ważniejsze od TOPS może stać się to, ile komputer ma pamięci
Przez ostatnie dwa lata producenci PC nauczyli rynek nowej jednostki: TOPS.
Skrót oznacza Tera Operations Per Second, czyli biliony operacji wykonywanych w ciągu sekundy. W kontekście AI informuje w dużym uproszczeniu, ile prostych operacji matematycznych może wykonać dany akcelerator przy określonym typie danych. 50 TOPS oznacza więc teoretyczną zdolność wykonania około 50 bilionów takich operacji na sekundę.
Ważne jest jednak zastrzeżenie: TOPS nie jest odpowiednikiem „inteligencji komputera” ani uniwersalną miarą szybkości AI. Dwa układy o podobnym wyniku TOPS mogą bardzo różnie radzić sobie z konkretnym modelem ze względu na architekturę, pamięć, przepustowość, używane formaty danych oraz optymalizację oprogramowania.
Microsoft ustalił dla pierwszych komputerów Copilot+ PC próg 40 TOPS wydajności NPU i od tego momentu praktycznie każda premiera procesora mobilnego przynosi kolejną porcję informacji o możliwościach akceleratora AI.
Przy dużych modelach językowych bardzo szybko okazuje się jednak, że sam TOPS nie wystarcza.
Model musi przede wszystkim zmieścić się w pamięci.
Parametry modelu, nazywane także jego wagami, są liczbami wyuczonymi podczas treningu. W ogromnym uproszczeniu opisują one siłę i sposób działania połączeń wewnątrz sieci neuronowej. Aby model mógł pracować, jego wagi muszą zostać zapisane i udostępnione procesorowi lub akceleratorowi.
Dla uproszczenia można przyjąć, że jeden parametr zapisany w formacie 16-bitowym potrzebuje dwóch bajtów. Model mający 70 miliardów parametrów wymagałby więc około 140 GB pamięci tylko na same wagi. Przy zapisie 8-bitowym byłoby to około 70 GB, a przy 4-bitowym - około 35 GB.
To wartości orientacyjne, nieuwzględniające dodatkowej pamięci potrzebnej między innymi na kontekst, KV cache oraz działanie samego środowiska.
| Liczba parametrów | 16 bitów | 8 bitów | 4 bity |
| 30 mld | ok. 60 GB | ok. 30 GB | ok. 15 GB |
| 70 mld | ok. 140 GB | ok. 70 GB | ok. 35 GB |
| 200 mld | ok. 400 GB | ok. 200 GB | ok. 100 GB |
| 1 bilion | ok. 2 TB | ok. 1 TB | ok. 500 GB |
I nagle 512 GB pamięci w Macu Studio przestaje wyglądać jak ocierająca się o absurd specyfikacja przygotowana dla człowieka montującego kilkanaście strumieni 8K.
M5 Ultra może korzystać z maksymalnie 512 GB zunifikowanej pamięci o przepustowości 1,2 TB/s. Procesor, GPU i pozostałe elementy układu korzystają z jednej puli, więc danych nie trzeba bezustannie kopiować między klasycznym RAM-em i osobną pamięcią karty graficznej.
NVIDIA DGX Spark oferuje z kolei 128 GB spójnej pamięci zunifikowanej o przepustowości 273 GB/s. Producent deklaruje możliwość uruchamiania modeli liczących do około 200 miliardów parametrów na jednej maszynie.
W przypadku klasycznych pecetów barierą często nie jest więc sama szybkość GPU, lecz ilość VRAM-u. Karta dysponująca 24 lub 32 GB pamięci może być niezwykle szybka, ale zwyczajnie nie pomieści dużego modelu.
W efekcie pojemność i przepustowość pamięci ponownie stają się jednymi z kluczowych parametrów komputera - tym razem nie z powodu klasycznych aplikacji, lecz lokalnych modeli AI.
Kwantyzacja - jak zmieścić słonia w komputerze
W poprzedniej tabeli pojawiły się wartości 8- i 4-bitowe. I tu dochodzimy do jednej z technologii umożliwiających cały obecny boom na lokalne modele.
Kwantyzacja w największym uproszczeniu polega na zapisaniu parametrów modelu z mniejszą precyzją.
Jeżeli zamiast wartości 16-bitowych wykorzystamy 8-bitowe, ilość pamięci potrzebna do przechowywania wag modelu może spaść mniej więcej o połowę. Przy 4 bitach oszczędność robi się jeszcze większa.
Nie jest to darmowa sztuczka.
Mniejsza precyzja może pogorszyć jakość odpowiedzi, a ostateczny efekt zależy od modelu, zastosowanego algorytmu i stopnia kompresji. Jednak przy dobrze dobranych metodach strata może być na tyle mała, że w praktycznych zastosowaniach korzyści pamięciowe zdecydowanie ją przewyższają.
Dobrym przykładem jest eksperyment AMD.
Firma wykorzystała cztery komputery Framework Desktop z Ryzen AI Max+ 395 i 128 GB RAM każdy. Połączono je przez sieć 5 Gb/s i za pomocą llama.cpp rozdzielono pomiędzy nie Kimi K2.5 klasy jednego biliona parametrów. Wykorzystana wersja modelu po kwantyzacji zajmowała około 375 GB.
Czym jest llama.cpp?
To rozwijany jako projekt open source silnik do uruchamiania dużych modeli językowych, szczególnie popularny w świecie lokalnej AI. Potrafi wykonywać inferencję na CPU i GPU różnych producentów, obsługuje mocno skwantyzowane modele, a mechanizm RPC pozwala rozłożyć pracę między kilka komputerów. Nie jest więc kolejnym modelem AI - to raczej warstwa oprogramowania umożliwiająca efektywne uruchomienie istniejącego LLM-a na dostępnych zasobach sprzętowych.
W eksperymencie AMD cztery osobne pecety działały właśnie dzięki temu jak rozproszone środowisko do inferencji Kimi K2.5.
Czy cztery niewielkie pecety zastąpiły serwerownię?
Nie.
Ale pokazały coś istotniejszego: granica między „modelem chmurowym” a „modelem, który można uruchomić samemu” przesuwa się w tempie, którego jeszcze niedawno trudno było się spodziewać.
Apple wcale nie jest pierwsze - cały rynek idzie w tę stronę
Najciekawszym elementem obecnej premiery Apple jest fakt, że nie jest to jedyna firma rozwijająca takie podejście do korzystania z możliwości AI.
Microsoft podczas Build 2026 przedstawił lokalne AI jako jeden z fundamentów przyszłości Windows. Oprócz Aion 1.0 Plan firma rozszerza Windows AI APIs poza pierwszą generację komputerów Copilot+ PC i rozwija Foundry Local jako środowisko pozwalające uruchamiać modele bezpośrednio na sprzęcie użytkownika.
Jeszcze ciekawsza jest koncepcja hybrydowego działania agentów. Mocny agent chmurowy może zaplanować zadanie, a prostsze czynności przekazać mniejszym modelom działającym lokalnie. Nie ma większego sensu angażować jednego z najdroższych modeli świata do każdej drobnej operacji wykonywanej w ramach wielogodzinnego procesu.
NVIDIA również przestała traktować lokalne AI jako niszową zabawę entuzjastów. DGX Spark umożliwia inferencję modeli do 200 mld parametrów oraz lokalne dostrajanie systemów mających do około 70 mld parametrów.
Producent rozwija jednocześnie RTX Spark dla Windows. Platforma ma oferować do 128 GB zunifikowanej pamięci i umożliwiać uruchamianie modeli liczących około 120 miliardów parametrów przy bardzo długich kontekstach. NVIDIA przedstawia te komputery wprost jako maszyny projektowane do pracy z lokalnymi agentami.
Podczas tegorocznych targów IFA firma pokazała również PAIR - Personal AI Router. To interesujący przykład innego podejścia do lokalnego klastra: PAIR nie skleja pamięci kilku komputerów w jeden wielki wirtualny akcelerator, ale kieruje poszczególne żądania inferencji do wolnego komputera w sieci. Dzięki temu kilka agentów może jednocześnie korzystać z mocy komputerów z RTX, DGX Spark, a nawet kompatybilnych Maców.
AMD demonstruje klastry z Ryzen AI Max.
Apple łączy Maki Studio przez Thunderbolt.
Microsoft przygotowuje Windows do wykonywania części pracy przez lokalne modele i agentów.
NVIDIA buduje oprogramowanie rozdzielające lokalną inferencję pomiędzy kilka komputerów.
Trudno te koncepcje traktować wyłącznie jako cztery niezależne eksperymenty.
Prywatność może być ważniejsza niż oszczędność
Koszt tokenów dobrze nadaje się do nagłówka, ale dla wielu firm największą zaletą lokalnego AI wcale nie muszą być pieniądze.
Wyobraźmy sobie agenta analizującego dokumentację techniczną przedsiębiorstwa, kod powstającego produktu, umowy z kontrahentami, dane klientów albo wewnętrzne raporty finansowe.
W klasycznej architekturze chmurowej informacje te muszą opuścić urządzenie użytkownika i zostać przesłane do infrastruktury dostawcy modelu. Oczywiście profesjonalne usługi oferują odpowiednie mechanizmy ochrony danych, polityki retencji i rozwiązania dla przedsiębiorstw. Nie zmienia to jednak faktu, że dane są przetwarzane poza lokalnym komputerem.
Przy modelu działającym lokalnie mogą fizycznie nie opuszczać organizacji.
Microsoft potwierdza, że Foundry Local wykonuje inferencję całkowicie na urządzeniu: prompt i wynik pozostają na komputerze, a po pobraniu modelu system może działać także bez połączenia z chmurą. Windows AI APIs również wykonują przetwarzanie lokalnie.
Podobnie działa LM Studio. Jeżeli użytkownik korzysta wyłącznie z pobranych modeli lokalnych, wiadomości, historia rozmów i dokumenty nie są wysyłane z urządzenia. Dopiero świadome wykorzystanie funkcji chmurowych, np. modelu online lub wyszukiwania internetowego, powoduje przetwarzanie części danych poza komputerem.
Dla działu prawnego, biura konstrukcyjnego, firmy tworzącej oprogramowanie albo organizacji pracującej z poufnymi dokumentami może to być argument ważniejszy niż kilka dolarów różnicy w kosztach inferencji.
Trzeba jednak zaznaczyć jedną rzecz.
Lokalny model nie oznacza automatycznie lokalnego systemu AI.
Jeżeli agent używa wyszukiwarki internetowej, zewnętrznego API, chmurowego OCR-u, serwisu do generowania obrazów albo innych narzędzi online, część danych nadal może opuszczać komputer. Prywatność zależy więc od całej architektury rozwiązania, a nie od samego miejsca przechowywania wag LLM.
Lokalna AI również ma rachunki do zapłacenia
Hasło „brak opłat za token” brzmi atrakcyjnie, ale nie oznacza oczywiście „AI za darmo”.
Najbardziej rozbudowany Mac Studio może kosztować kilkanaście tysięcy dolarów. Reuters wskazuje, że ceny najdroższych konfiguracji nowych komputerów Apple mogą zbliżać się nawet do 20 tys. dolarów.
Do tego dochodzi energia, czas administratorów, kopie zapasowe, bezpieczeństwo, aktualizacje, wymiana sprzętu i fakt, że komputer kupiony dziś zaczyna się amortyzować od pierwszego dnia.
Chmura ma tymczasem kilka przewag trudnych do zakwestionowania.
Pozwala niemal natychmiast zwiększyć potrzebną moc obliczeniową. Jeżeli przez większość miesiąca firma wykorzystuje AI sporadycznie, a raz na tydzień potrzebuje ogromnych zasobów, zakup sprzętu działającego przez większość czasu na pół gwizdka raczej trudno nazwać sensowną ekonomicznie inwestycją.
Chmura daje również natychmiastowy dostęp do nowych modeli. Nie trzeba sprawdzać, czy mieszczą się w pamięci, czy lokalne środowisko je obsłuży ani czy potrzebny jest nowy sterownik GPU.
I wreszcie - najpotężniejsze systemy pozostają zamknięte.
Nie pobierzemy GPT-6 Astra na firmową stację roboczą. Nie postawimy sobie lokalnie Claude Opus 5.5. Najbardziej zaawansowane modele komercyjnych dostawców nadal będą więc dostępne przede wszystkim poprzez ich własną infrastrukturę.
Dlatego przewidywanie śmierci chmury byłoby równie rozsądne, jak przewidywanie śmierci komputerów osobistych po upowszechnieniu Amazon Web Services i innych wielkich platform cloud computing.
Oba modele wykorzystania komputerów po prostu znalazły dla siebie miejsce.
Z lokalnym i chmurowym AI najprawdopodobniej będzie podobnie.
Najbardziej prawdopodobna przyszłość to hybryda
W rzeczywistych zastosowaniach wybór prawdopodobnie nie będzie brzmiał:
lokalnie albo w chmurze.
Znacznie bardziej logiczny jest model:
lokalnie tam, gdzie wystarcza własny sprzęt - chmura wtedy, gdy potrzebne są możliwości najmocniejszych modeli lub dodatkowa skala.
Wyobraźmy sobie firmowego agenta pracującego z tysiącami wewnętrznych dokumentów.
Lokalnie może indeksować pliki, generować embeddingi, wyszukiwać informacje, klasyfikować dokumenty, przygotowywać streszczenia i wykonywać proste operacje na danych. Średniej wielkości lokalny model może obsługiwać większość codziennych poleceń.
Dopiero kiedy pojawi się problem wymagający wyjątkowo złożonego rozumowania, agent wysyła odpowiednio przygotowany fragment zadania do Astry albo Claude'a.
Nie trzeba więc przesyłać do zewnętrznego modelu całego firmowego archiwum. Nie trzeba również płacić za wykorzystanie drogiego systemu do poprawiania literówki, klasyfikowania faktury czy streszczania krótkiego dokumentu.
Jednocześnie użytkownik nie rezygnuje z dostępu do najbardziej zaawansowanych systemów wtedy, gdy ich możliwości rzeczywiście są potrzebne.
I właśnie taki model może mieć największy wpływ na rynek komputerów.
Nie dlatego, że każdy z nas potrzebuje bilionowego LLM-a na biurku.
Wręcz przeciwnie.
Większość zadań może wykonywać znacznie mniejszy model, a najdroższy system frontier zostanie wykorzystany tylko wtedy, kiedy jego większe możliwości rzeczywiście będą potrzebne.
Po latach chmury komputer osobisty znowu może zacząć mieć znaczenie
Przez sporą część ostatnich dwóch dekad kierunek rozwoju IT wydawał się oczywisty.
Coraz więcej danych przechowywaliśmy poza komputerem. Coraz więcej aplikacji przenosiło się do przeglądarki. Obliczenia trafiały do centrów danych. W skrajnym wariancie lokalne urządzenie miało być niemal tylko ekranem, klawiaturą i połączeniem z usługą działającą gdzie indziej.
Generatywna AI może ten trend częściowo odwrócić.
Jeżeli komputer użytkownika ma przez cały dzień analizować dokumenty, uruchamiać lokalnych agentów, przetwarzać kod, generować obrazy i wykonywać inferencję modeli mających dziesiątki lub setki miliardów parametrów, ponownie zaczyna mieć znaczenie to, co fizycznie znajduje się wewnątrz obudowy.
Nie tylko procesor.
Także ilość pamięci, jej przepustowość, GPU, NPU, rozmiar SSD, szybkość interfejsów pomiędzy urządzeniami oraz efektywność energetyczna całej platformy.
Apple widzi w tym możliwość wykorzystania architektury zunifikowanej pamięci swoich układów.
NVIDIA tworzy nową klasę osobistych superkomputerów AI.
AMD pokazuje, że cztery niewielkie desktopy mogą wspólnie uruchomić model klasy biliona parametrów.
Microsoft przygotowuje Windows do świata, w którym system operacyjny będzie udostępniał aplikacjom lokalne modele oraz infrastrukturę dla agentów.
Każda z tych firm ma własny interes w promowaniu takiej wizji. Apple chce sprzedawać drogie Maki, NVIDIA nowe platformy sprzętowe, AMD procesory dysponujące ogromnymi pulami pamięci, a Microsoft potrzebuje kolejnego powodu, dla którego firmy miałyby wymieniać komputery na nowsze.
Nie znaczy to jeszcze, że lokalne AI wygra z chmurą.
Ale oznacza coś innego.
Po raz pierwszy od początku obecnego boomu generatywnej AI chmura przestaje być jedynym oczywistym miejscem, w którym musi znajdować się inteligencja.
Nowy Mac Studio jest efektownym symbolem tej zmiany, ale nie jej przyczyną. Jest jednym z wielu produktów pokazujących, że granica między pecetem, stacją roboczą i małym serwerem AI zaczyna się zacierać.
Możliwe więc, że jednym z bardziej przewrotnych skutków rewolucji AI będzie renesans bardzo klasycznej idei:
mocnego komputera stojącego na naszym własnym biurku.
Tyle że tym razem zamiast arkusza kalkulacyjnego czy Photoshopa będzie na nim pracował agent mogący przez kilka godzin analizować dokumenty, pisać kod i wykonywać zadania bez pytania centrum danych o zgodę na każdy kolejny token.
Chmura nigdzie się nie wybiera.
Ale po raz pierwszy od kilku lat wygląda na to, że nie cała sztuczna inteligencja musi mieszkać właśnie tam.